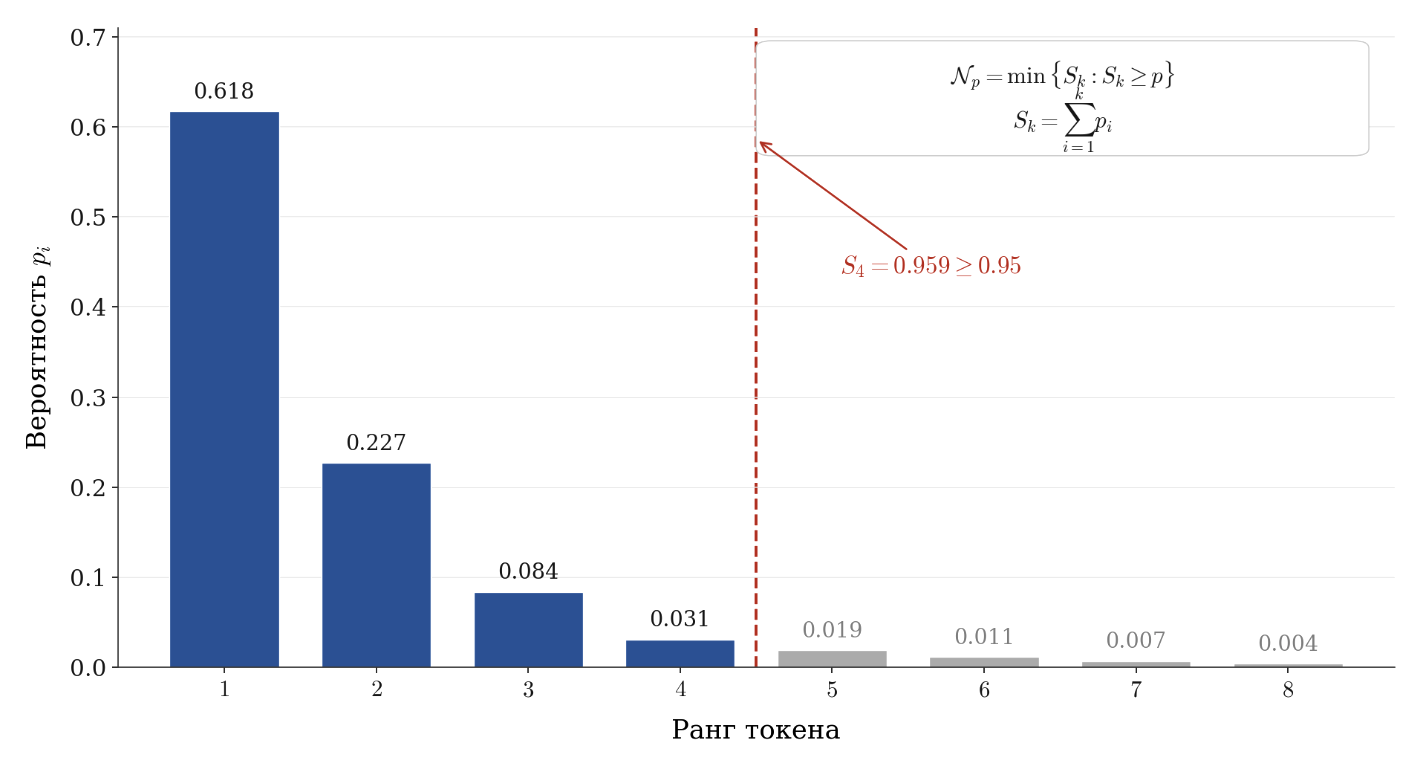
Независимые как понятия, зависимые как операции: параметры семплирования в LLM-инференсе
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет»…
Хабр
Повний текст, переклад і AI-підсумок — після входу
- Повний текст статті вашою мовою
- AI-підсумок і переклад з оригіналу
- Той самий акаунт працює в додатку Suviy
Схожі матеріали
Коментарі
Увійдіть, щоб долучитися до обговорення. Увійти
Коментарів поки немає.