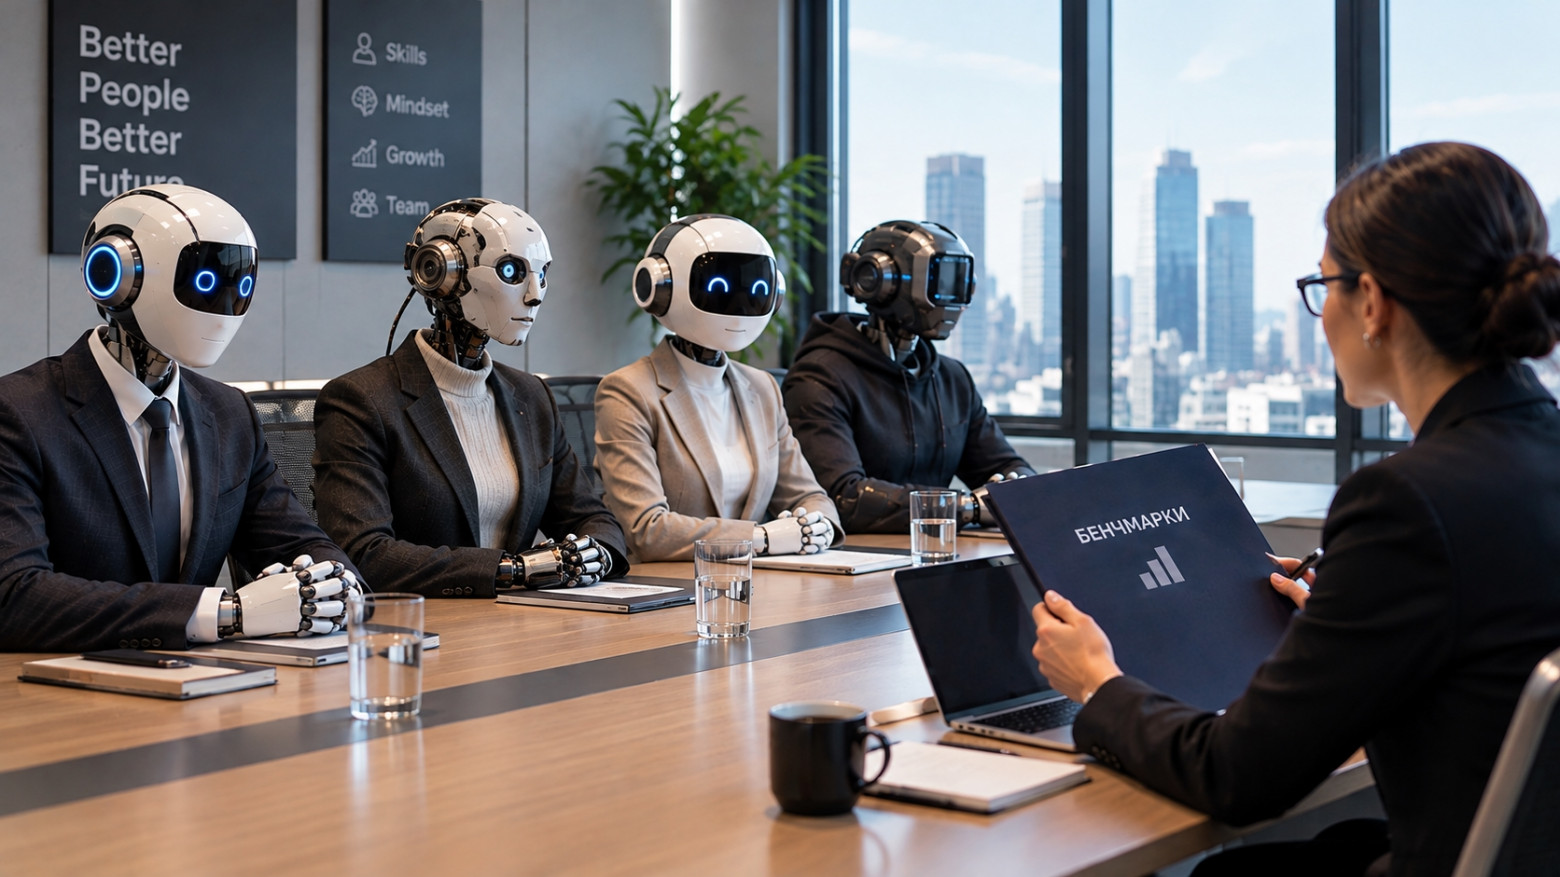
Из какой LLM получится хороший виртуальный сотрудник, или Почему валятся бенчмарки моделей для генерации кода
В феврале 2026 года OpenAI рекомендовала оценивать ИИ-агентов для программирования по бенчмарку SWE-Bench Pro. Но уже 8 июля отозвала собственную рекомендацию, признав, что примерно 30% задач SWE-Benc…
Хабр
Full text, translation and AI summary — after signing in
- The full article in your language
- AI summary and translation from the original
- The same account works in the Suviy app
Related coverage
Comments
Sign in to join the conversation. Sign in
No comments yet.