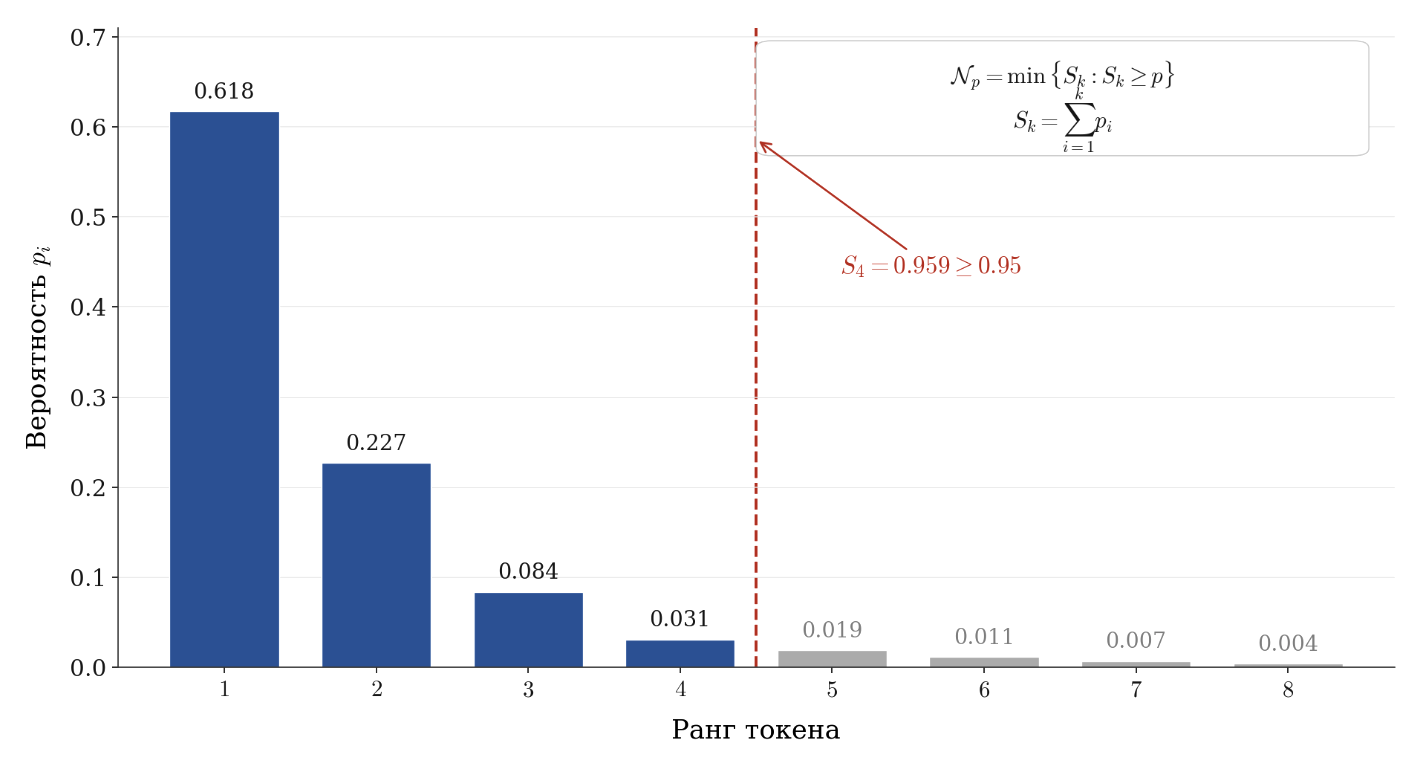
Независимые как понятия, зависимые как операции: параметры семплирования в LLM-инференсе
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет»…
Хабр
Полный текст, перевод и AI-сводка — после входа
- Полный текст статьи на вашем языке
- AI-сводка и перевод с оригинала
- Тот же аккаунт работает в приложении Suviy
Похожие материалы
Комментарии
Войдите, чтобы присоединиться к обсуждению. Войти
Комментариев пока нет.